Nel mondo AI siamo abituati alla presentazione di modelli sempre più capaci, ma è raro imbattersi in un rilascio che migliora le prestazioni e allo stesso tempo abbassa il costo d’uso. È quello che sostiene Anthropic con Claude Opus 5.5, una versione che promette di far risparmiare tempo e denaro a chi lavora ogni giorno con l’intelligenza artificiale.
Segui TuttoTech.net su Google Discover
Claude Opus 5.5: più potente e più economico
Attraverso il profilo ClaudeAI su X, Anthropic ha annunciato la pubblicazione del nuovo modello con due affermazioni piuttosto nette: Opus 5.5 si comporta in modo simile a Claude Fable 5.1 per la maggior parte dei compiti e costa il 40% in meno rispetto a Opus 5. Se i numeri reggono, il nuovo arrivato risulta più forte e allo stesso tempo più leggero per chi consuma credito a ritmi sostenuti.
Introducing Claude Opus 5.5, the first model in our new Claude 5.5 family.
It performs at the level of Claude Fable 5.1 for most tasks, and costs 40% less to run than Opus 5. pic.twitter.com/Q9C2VKQ79f
— Claude (@claudeai) September 22, 2026
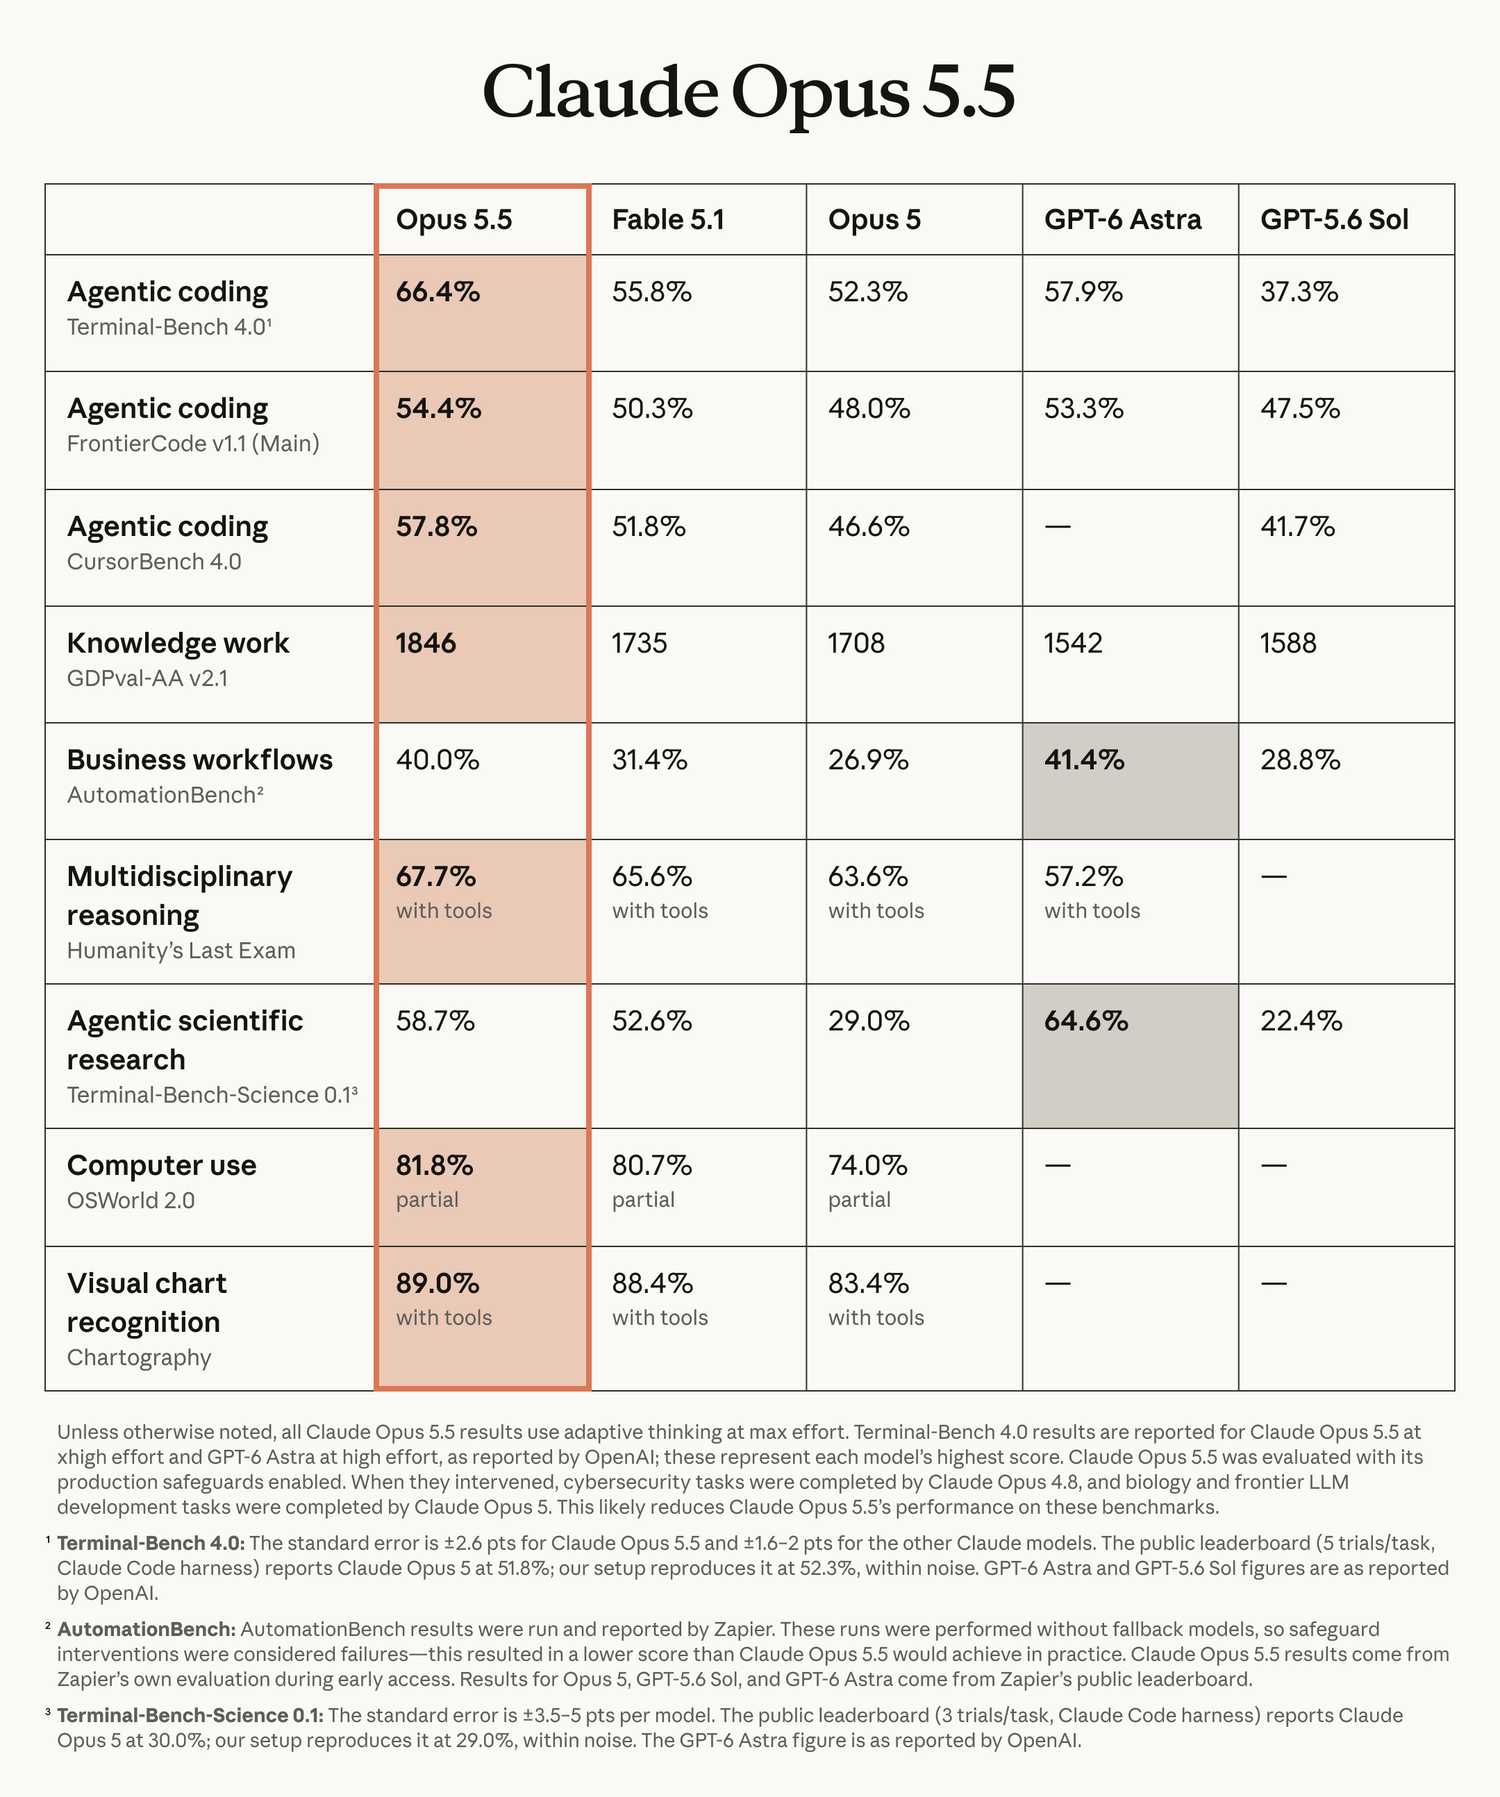
Il post pubblicato dall’azienda mostra un grafico con i guadagni di performance, e i valori non sono marginali. Si parla di un incremento di circa 11 punti percentuali sulle capacità di agentic coding misurate con Terminal-Bench 4.0, di 6 punti percentuali su CursorBench 4.0 e di un punteggio più alto anche sul lavoro di tipo conoscitivo. Tradotto in pratica, il modello completa più attività in autonomia, scrive codice più affidabile e gestisce meglio i compiti che richiedono ragionamento e contesto.
Anthropic sostiene inoltre che Opus 5.5 superi il modello più grande della generazione Fable in numerosi benchmark e che abbia portato a termine con successo una serie di task informali che Fable non era riuscito a chiudere. C’è poi un cambiamento nel modo in cui il modello comunica: è meno incline a usare gergo tecnico e tende a collocare le informazioni importanti all’inizio dei messaggi. Un dettaglio che sembra piccolo, ma che cambia la leggibilità delle risposte, soprattutto quando si lavora su sessioni lunghe o con più agenti in parallelo, uno degli strumenti di collaborazione più discussi del momento.
Come si comporta contro GPT-6 Astra
Nei benchmark pubblicati da Anthropic, Opus 5.5 batte GPT-6 Astra di OpenAI nella maggior parte delle categorie: segna il 66,4% su Terminal-Bench 4.0 contro il 57,9% di Astra, il 54,4% su FrontierCode v1.1 contro il 53,3% dell’avversario, e guida anche su GDPval-AA v2.1 con un Elo di 1846 contro 1542.
Astra, però, si prende la rivincita in due ambiti specifici: AutomationBench, il test sui workflow aziendali gestiti da Zapier, e Terminal-Bench-Science, la prova di ricerca scientifica agentiva, dove totalizza il 64,6% contro il 58,7% di Opus 5.5. Sono due nicchie che contano, perché indicano che la supremazia non è totale e che la scelta del modello dipende ancora dal tipo di lavoro da portare a termine.
La notizia che per molti pesa di più riguarda la voce di costo principale per agenti e coding: le cache read calano del 60%, scendendo a 0,20 dollari per milione di token, mentre le cache write passano a 5 dollari da 6,25. Sono proprio queste voci a pesare quando si fanno girare agenti che rileggono continuamente lo stesso contesto, e ridurle di oltre la metà cambia il conto a fine mese più di quanto non faccia il prezzo nominale del modello.
Prezzi, modalità fast e nuovi limiti di utilizzo
Se Opus 5 costava 5 dollari per milione di token in input e 25 per milione in output, la nuova versione scende a 4 dollari e 20 dollari. Il risparmio si somma a quello delle cache, e il risultato è un modello più forte a un prezzo più basso rispetto a quello usato fino a ieri. Claude Code e la piattaforma Claude ricevono anche una modalità fast fino a 2,5 volte più veloce, con un listino di 8 dollari per milione di token in input e 40 per milione in output: si paga di più per la rapidità, ma è un’opzione che può far comodo quando il tempo di attesa è il collo di bottiglia.
Anthropic ha anche innalzato i limiti di utilizzo orari (5 ore) per i piani Pro, Max e Team e offre agli abbonati un reset del rate limit salvabile, da usare quando preferiscono, senza sprecare l’occasione al momento sbagliato. Un tester ha completato una migrazione di codice da 680.000 righe in meno di un giorno, un lavoro che a un intero team di ingegneri avrebbe richiesto settimane: è il tipo di esempio che rende concreta la differenza tra i numeri dei benchmark e la vita reale di chi sviluppa.
Sul fronte della lineup, Sonnet 5.5 e Haiku 5.5 arriveranno “nelle prossime settimane” con miglioramenti simili, quindi la spinta al ribasso dei costi non dovrebbe fermarsi al modello di punta. Nel frattempo, il modello è stato testato prima del rilascio da valutatori esterni, tra cui Frontier Design e METR, e nel test di audit comportamentale automatizzato, il più completo mai eseguito da Anthropic sull’allineamento, Opus 5.5 risulta il modello con il punteggio più alto mai registrato dall’azienda.
Sul versante della sicurezza, Anthropic dichiara che Opus 5.5 è paragonabile a Mythos per capacità in biologia e cybersicurezza, il che significa che al rilascio si applicano le stesse misure di sicurezza previste per il modello Fable. Tra i limiti previsti ci sono le restrizioni sull’uso dei modelli per scoprire exploit in programmi compilati o per sviluppare armi biologiche riconoscibili. Da una parte un modello più economico e più capace, dall’altra un impianto di salvaguardie che continua a stringere su alcuni ambiti sensibili.
I nostri contenuti da non perdere:
- 🔝 Importante: Volantino Lidl, da giovedì 24 settembre tornano le offerte Parkside e Ultimate Speed per auto e garage
- 📚 Approfitta ora e studia (o gioca) meglio: i migliori notebook MSI in offerta per il Back To School 2026
- 💰 Risparmia sulla tecnologia: segui Prezzi.Tech su Telegram, il miglior canale di offerte
- 🏡 Seguici anche sul canale Telegram Offerte.Casa per sconti su prodotti di largo consumo